企业本地部署AI大模型:安全性的关键考量与实践路径

随着AI大模型进入业务场景,越来越多企业开始关注本地部署。与直接调用公有云服务相比,本地部署将模型运行在企业自有或专有环境中,数据不必离开组织边界,因而被视为满足数据合规和保密要求的重要路径。但需要明确的是,本地部署并不等于绝对安全,它改变的是风险分布,而非消除风险。
本地部署为何受到关注
企业选择本地部署AI大模型,核心诉求通常集中在三点:一是敏感数据不出内网,降低数据外流风险;二是可根据行业和业务需要调整模型与权限策略;三是网络隔离条件下仍能提供智能能力。对于涉及客户信息、研发资料、财务数据或生产知识的企业,这些诉求具有现实意义。
然而,模型进入企业内网后,安全责任也随之转移。基础设施、模型文件、接口服务、账号权限和日志审计,都需要企业自行设计和持续维护。
本地部署仍需面对的安全风险
数据与网络边界风险
本地部署减少了数据向外部服务传输的环节,但内部滥用、越权访问和误操作依然存在。若知识库、向量数据库或缓存目录权限配置不当,敏感内容可能在部门之间扩散。模型服务若暴露在办公网,也可能成为新的攻击入口。
模型与供应链风险
AI大模型的文件、依赖组件和推理框架来源复杂。未经审查的模型权重、插件或第三方工具可能引入恶意代码、后门或不兼容问题。企业应建立模型引入评估机制,对来源、许可、完整性和依赖关系进行核验。
使用行为与输出风险
提示词注入、恶意诱导和数据投毒等风险并不会因本地部署而消失。模型可能生成不准确、不合规或泄露上下文信息的内容。若缺少输入过滤、输出审核和敏感信息识别,业务人员直接使用生成结果可能带来合规与决策风险。
企业落地建议
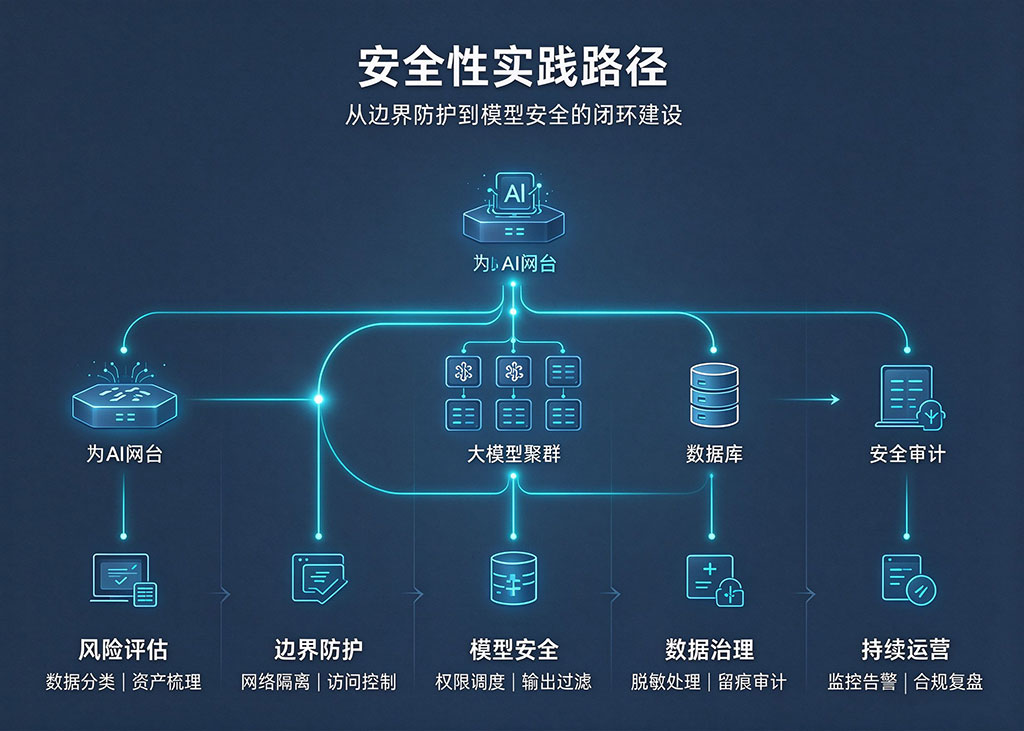
明确边界与分级:按数据敏感程度划分使用场景,确定哪些模型、哪些功能允许处理哪类数据。
强化身份与权限:实行最小权限原则,区分管理员、开发者和普通用户,关键操作保留审批与审计记录。
做好网络隔离:将模型服务部署在受控区域,限制不必要的对外连接,并对接口进行认证、限流和监控。
建立模型准入与更新机制:核验模型来源和文件完整性,跟踪安全更新,避免随意加载未知插件。
完善日志与内容治理:记录关键访问和调用行为,对输入输出进行必要的敏感信息检测与合规审核。
结语
本地部署AI大模型的价值在于增强企业对人、数据和系统的控制力,但安全能力需要同步建设。企业应将本地部署视为一项持续治理工程,在数据边界、权限控制、模型供应链和运营审计之间形成闭环。唯有如此,才能在享受大模型效率提升的同时,守住安全与合规底线。
