本地部署开源大模型全流程:以 DeepSeek 4.1 Flash 为例,从服务器配置到内外网对接

把大模型部署到自己的机房里,已经从少数团队的探索变成了很多企业的常规需求:数据不出内网、调用成本可控、能力可以按业务定制。但对大多数后台与运维同学来说,真正难的是一连串工程问题——用什么机器、跑什么框架、怎么让内网系统调用、外网又该如何安全地开放。本文以开源版 DeepSeek 4.1 Flash 为例,把这条链路拆开讲清楚。需要提醒的是,不同版本的参数规模、量化方式和授权范围差异较大,具体资源需求请以官方发布说明和实测结果为准,本文不给出固定数值。
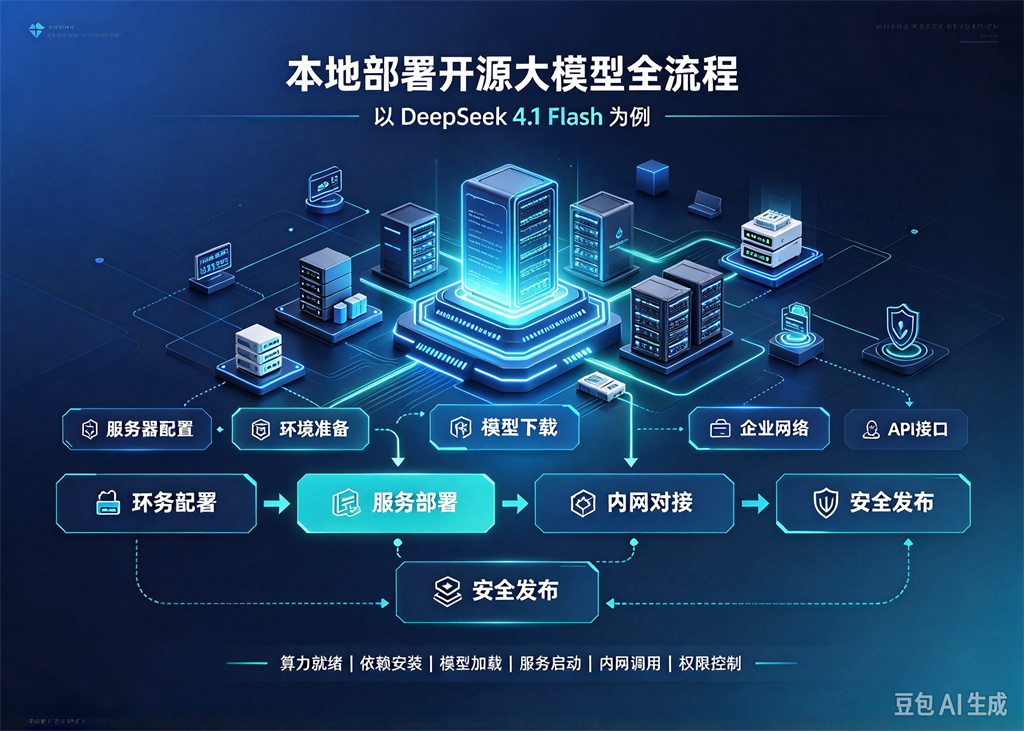
一、先想清楚:本地部署解决什么问题
本地部署的价值通常集中在四点:
数据合规:请求与语料不离开自有网络,便于审计与分级管理。
成本与可控性:高频调用场景下,长期成本可能低于按量付费;版本、参数、上下文长度由自己决定。
可定制:可以结合内部知识库、权限体系做二次封装。
稳定性:不受外部服务波动与限流影响,便于纳入既有运维体系。
但如果调用量很小、对时延不敏感、也没有数据合规要求,直接使用成熟 API 往往更划算。部署前先回答“为谁服务、每天多少请求、能接受多长等待”,后面的选型才有依据。
二、模型选型与资源评估
1. 硬件看什么
GPU 显存:决定模型能否加载、上下文能开多长、并发能撑多少,是最关键的指标。
CPU 与内存:负责权重加载、前后处理与请求调度,内存不足会拖慢首字延迟。
磁盘:模型权重文件体积较大,建议单独挂载数据盘,并预留多版本空间。
网络:内部多机推理或对接外部存储时,带宽与延迟会直接影响吞吐。
2. 推理框架怎么选
常见选择包括 vLLM、SGLang、llama.cpp、Ollama、TensorRT-LLM 等。面向生产的高并发 API 服务,通常优先考虑支持连续批处理与分页注意力的方案;面向单机验证或边缘设备,轻量框架更容易上手。量化能显著降低显存占用,但会带来一定精度损失,建议用业务真实问题做对比评测后再决定。
三、部署实施的关键步骤
环境准备
先固定驱动、CUDA 与推理框架的版本组合,避免“环境漂移”。建议用容器镜像固化依赖,并在镜像中内置健康检查脚本。
启动推理服务
从官方渠道获取模型权重并校验完整性,按显存情况设置并行度、最大上下文与最大并发。启动后先做小流量验证:短问答、长文本、流式输出各测一轮,确认输出正常、显存无持续增长。
健康检查与压测
暴露独立的健康检查接口,纳入监控系统;再用接近真实分布的请求做压测,记录首字延迟、单请求耗时与吞吐随并发变化的曲线,作为后续容量规划的依据。
四、内网对接:把模型变成内部服务
推理服务本身只是“引擎”,业务要的是“接口”。推荐在内网做一层统一接入:
统一协议:对外提供 OpenAI 兼容的 HTTP 接口,降低各业务系统的接入成本。
API 网关:集中做身份认证、密钥管理、配额与限流,按业务线分配调用额度。
反向代理:由 Nginx 等代理转发,处理超时、重试与负载均衡。
可观测性:记录调用量、延迟、错误率与 Token 消耗,便于成本分摊与故障定位。
注意不要把所有内网终端直接指向推理端口,否则鉴权缺失、流量突增都无从拦截。网关层还能做请求脱敏与内容审计。
五、外网对接:安全永远优先
“外网可用”不等于“公网裸奔”。稳妥的做法是:
推理服务始终只监听内网地址,不直接暴露公网端口。
外网入口统一走反向代理并启用 HTTPS,前置 WAF 做基础防护。
强制身份认证:网关签发短期令牌或 API Key,配合 IP 白名单与来源校验。
对高敏场景优先使用 VPN 或专线接入,而不是公网直连。
开启全量访问日志与审计,设置异常调用告警,按租户限流并设置日配额上限。
如果面向公网用户,还需考虑防滥用、内容安全过滤与灰度发布策略。
六、常见坑与经验
上下文开太大:挤占显存导致并发骤降,建议按业务设定上限。
代理缓冲干扰流式输出:需要在代理层关闭响应缓冲。
长连接超时:长文本生成易被网关提前断开,需调整超时设置。
版本管理混乱:为模型与镜像打标签,保留可回滚的历史版本。
七、结语
本地部署不是一次性的“装好就完事”,而是一套包含资源规划、服务治理与安全边界的长期工程。以 DeepSeek 4.1 Flash 这类开源模型为起点,先把内网接口做稳、再把外网入口守好,模型能力才能真正变成业务可依赖的基础设施。
